使用阿里云向量检索服务DashVector实现关键词感知的向量检索
来源:互联网
时间:2026-08-25 07:35:26
一.概述
本文就以一个实际搭建的房源检索服务为切入点,详细拆解如何借助阿里云的 DashVector 实现“带有关键词感知的向量检索”。至于“关键词感知的向量检索”本身的定义和机制,阿里云官方文档已经有较完整的说明,这里不再重复展开,重点补充文档里着墨不多、但在真正落地时很关键的实操部分。
二.操作过程
2.1 DashVector API-KEY 申请
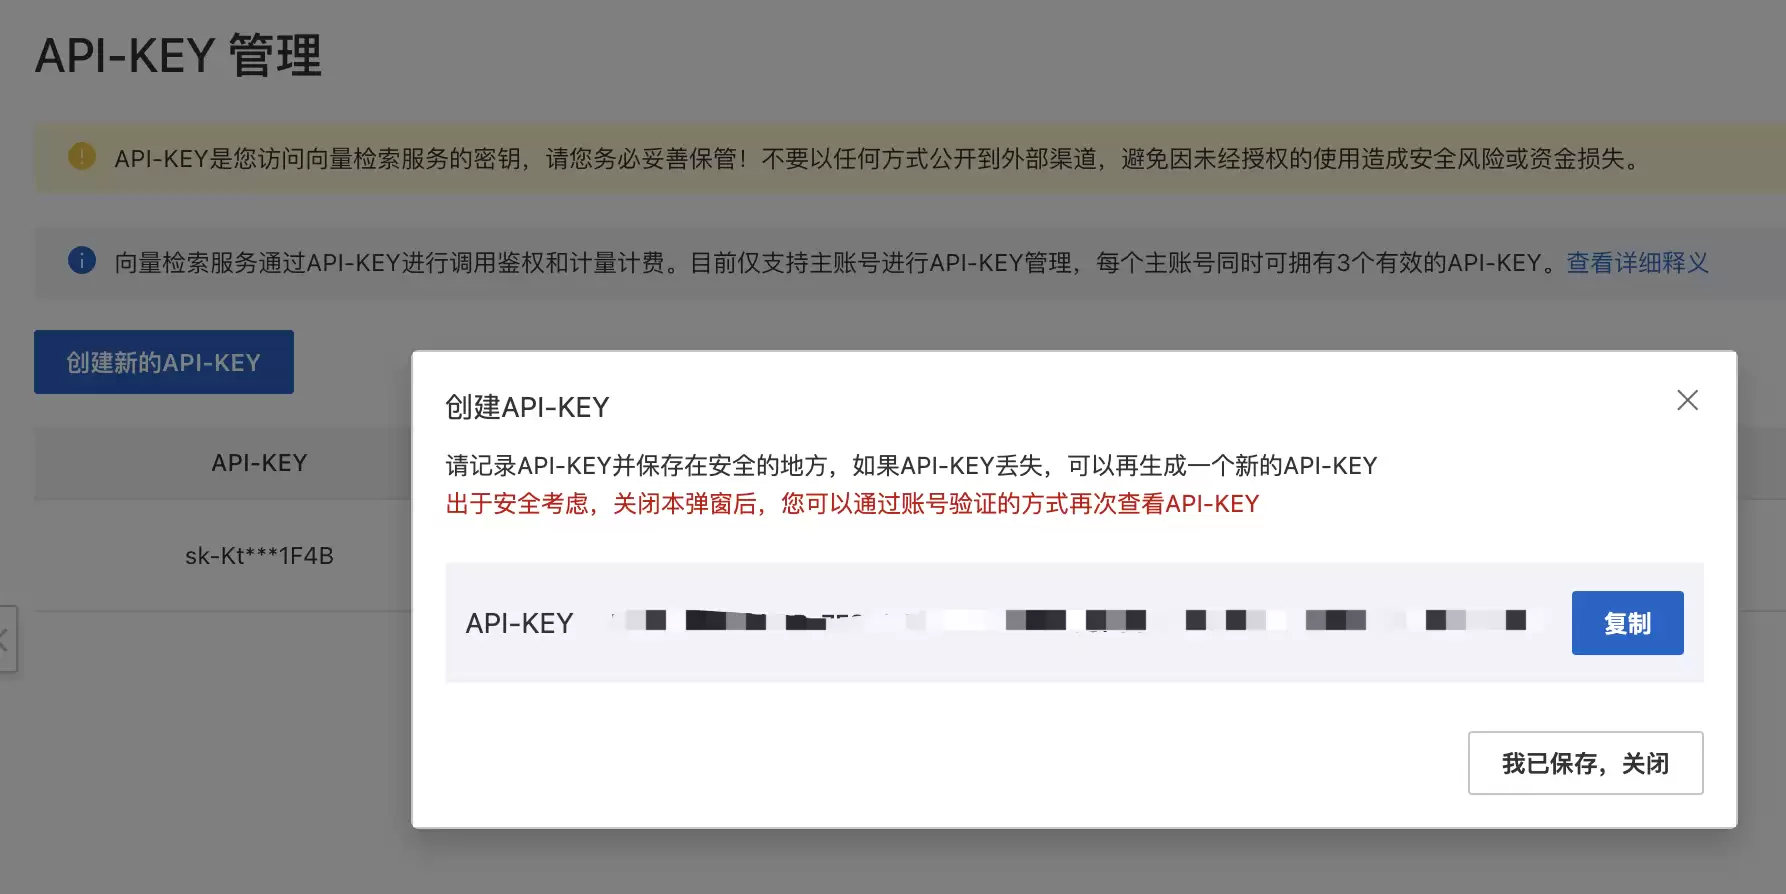
登录 阿里云向量检索服务 DashVector 控制台 点击创建 api-key申请。注意:关闭后不可复制
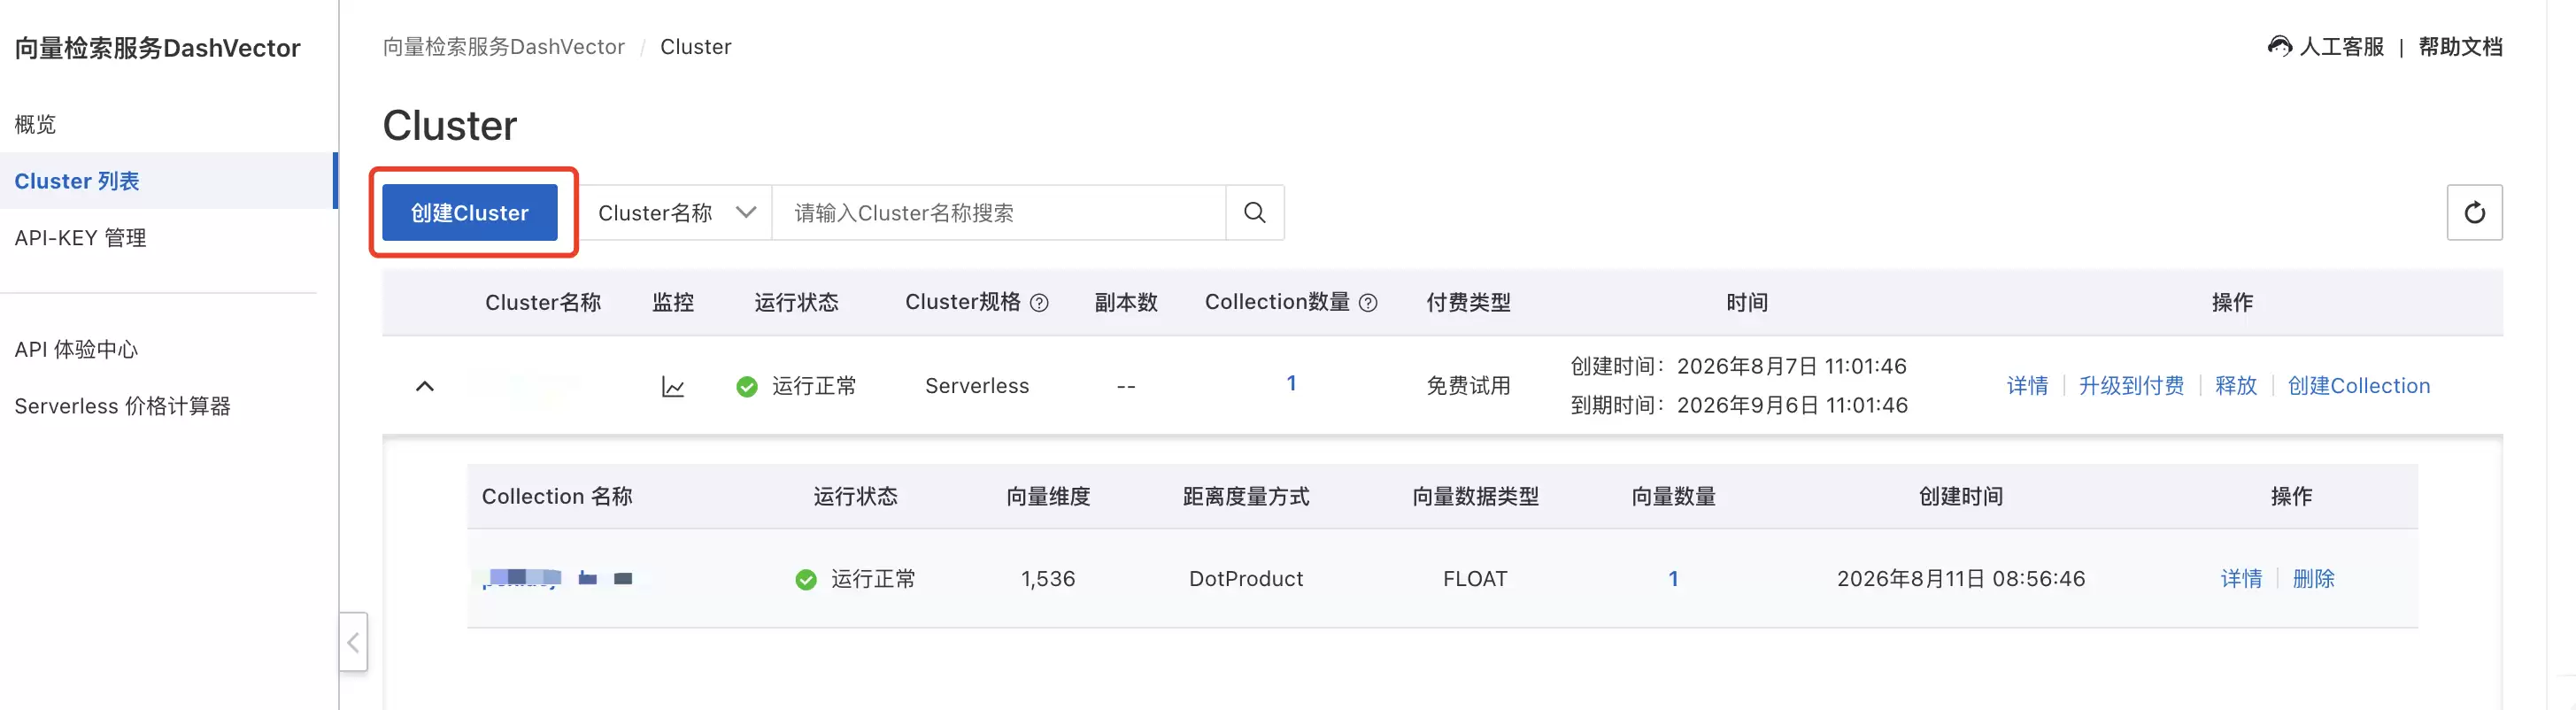
2.2 创建 Cluster
创建集群(可以类比成关系型数据库里的一个数据库),阿里云会给一定的免费额度供练习使用。
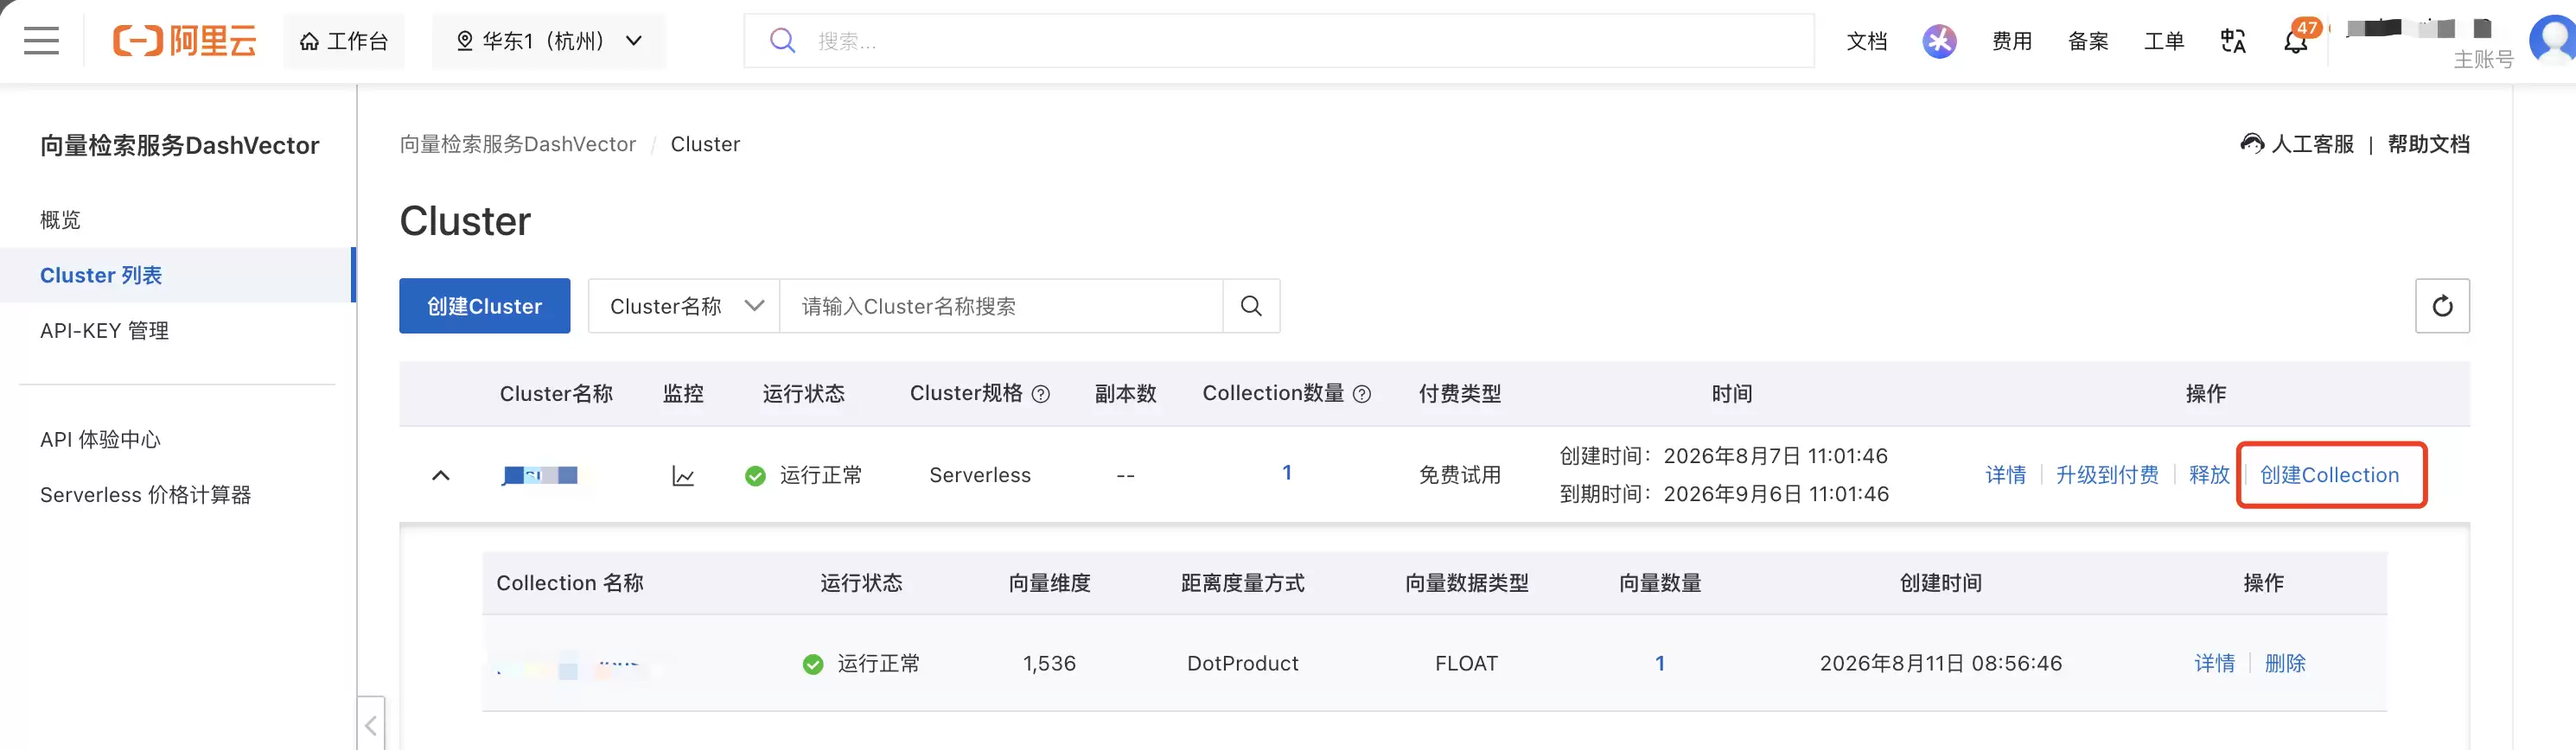
2.3 创建collection
可以类比成关系型数据库的一个表
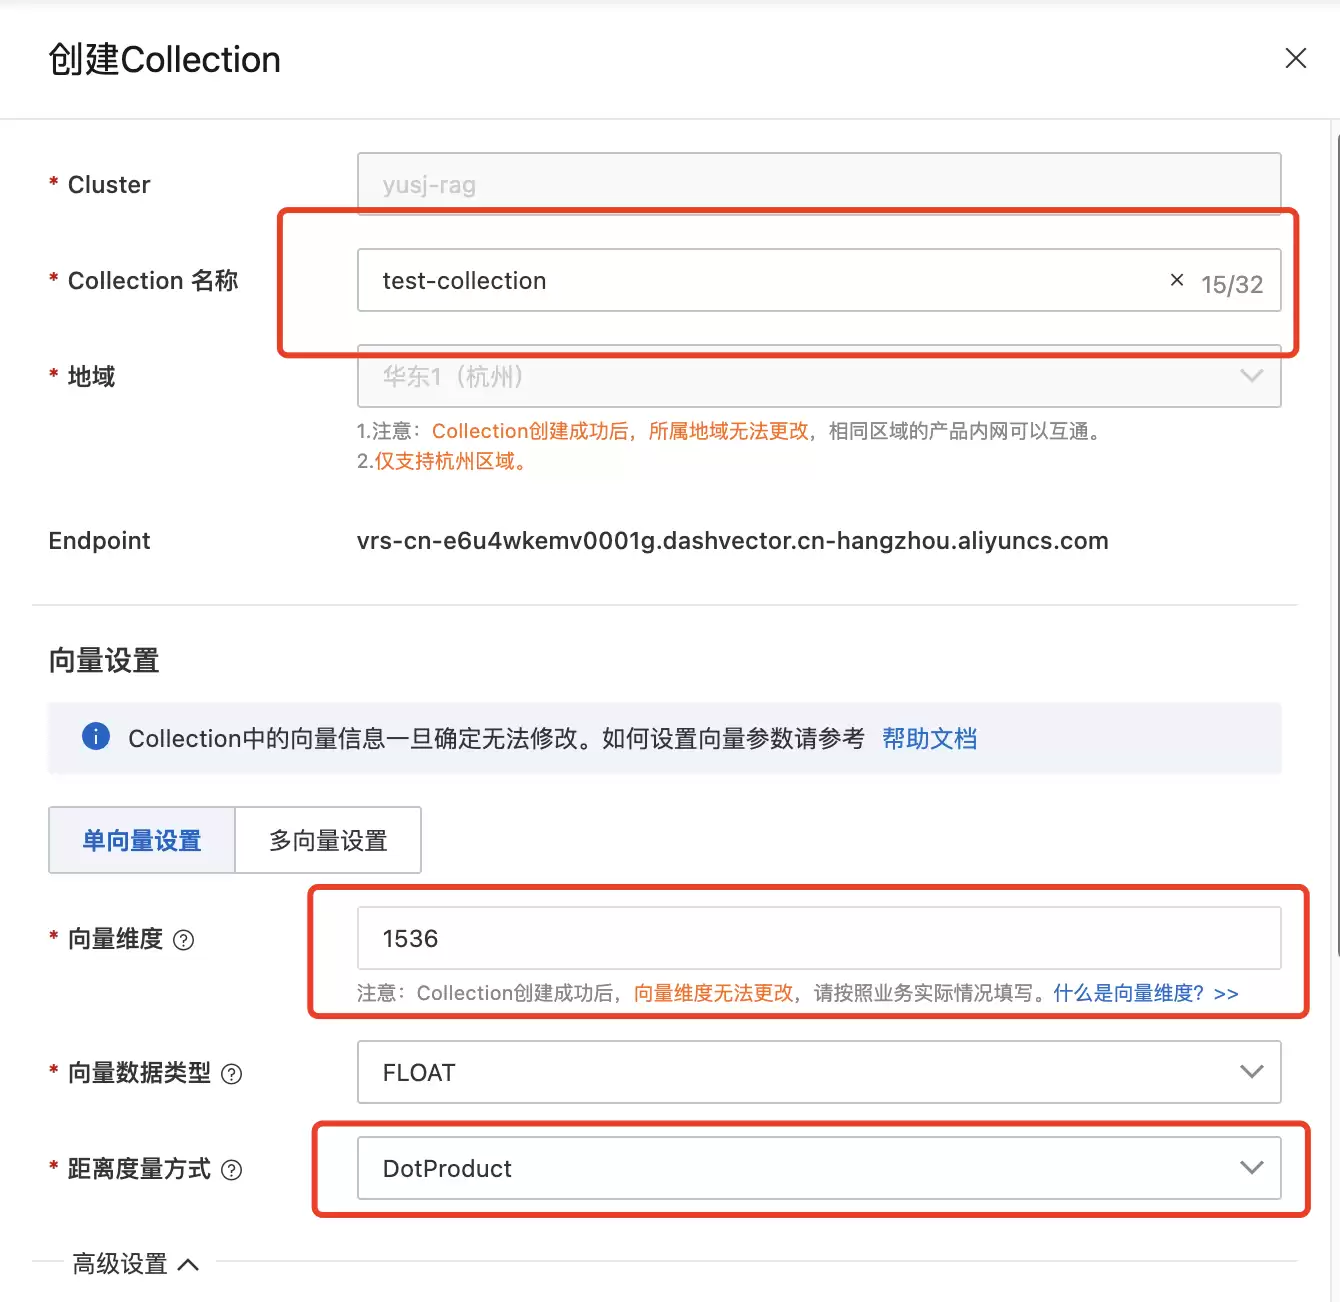
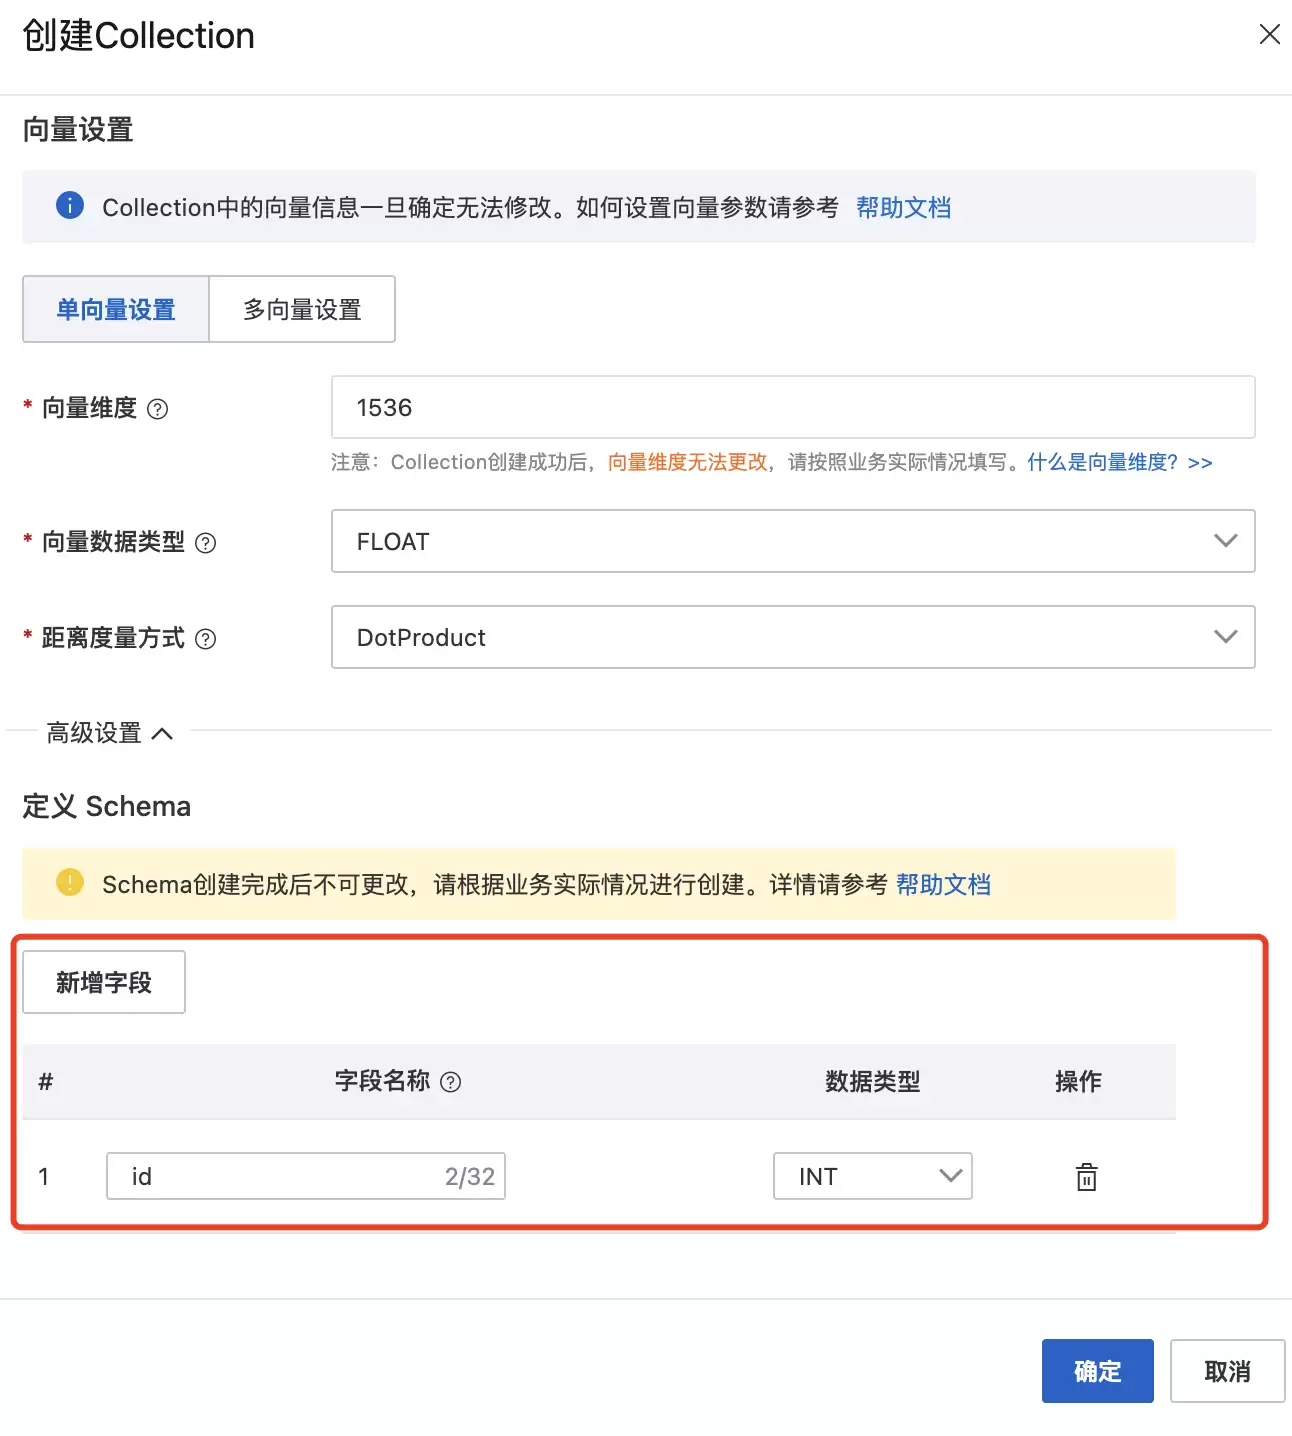
所以我们创建完成的 collection 的一条数据的结构如下:
往 collection 里写入数据时,组织方式也得保持一致:先通过 embeding 模型生成 vector,再借助对应的稀疏向量生成工具 DashText 产出稀疏向量,最后把它们和自定义的 fields 一起组装后存入 collection。
检索时,我们将 关键词同样处理成,稠密和稀疏向量,进行匹配召回就可以了。召回的信息中,会附带我们自己的 fields.这样就召回了我们提前预定的关键信息。
2.4 生成及插入向量数据
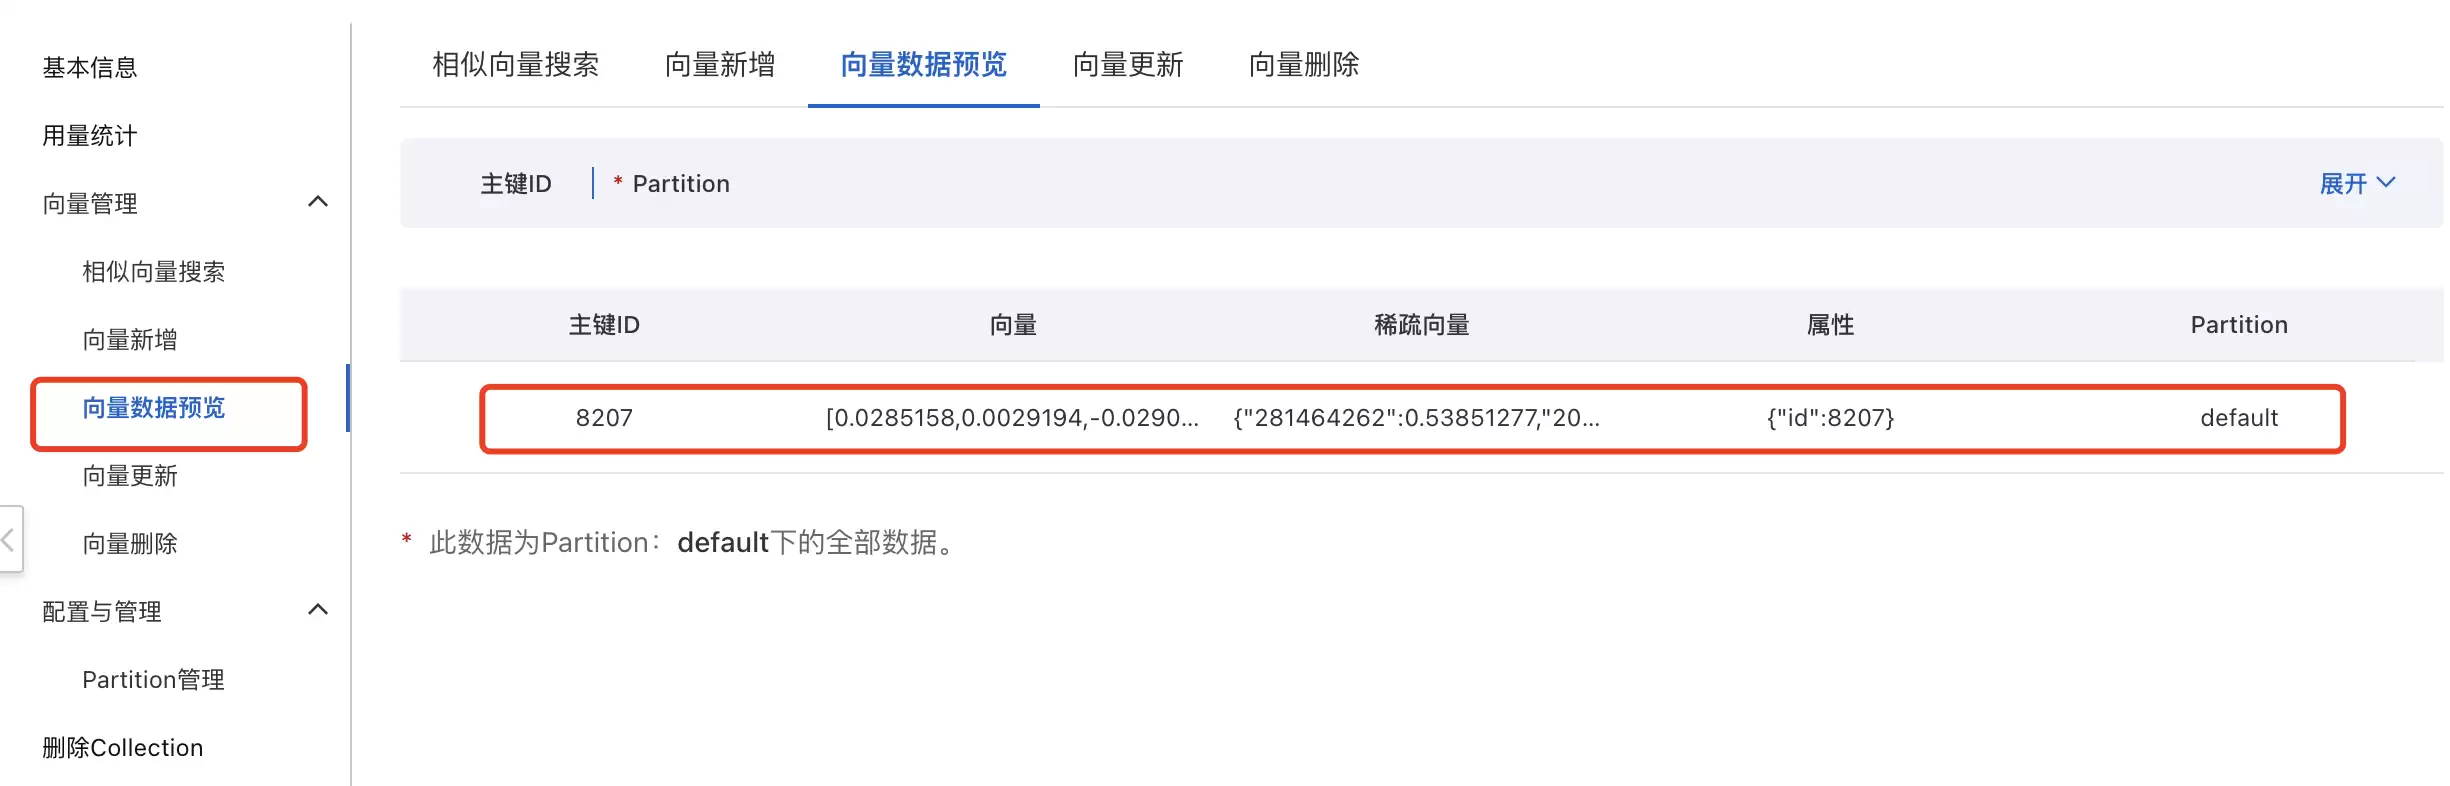
我的原始数据格式 house_vectors.json 这里我希望通过描述信息,召回对应房源 id 即可,所以 schema 中仅定义了一个 id.上传成功后,我们在平台的 collection 中可以看到导入的数据,至此我们的向量数据处理全部完成。可以看到存储的是向量信息。
2.5 向量检索
三.注意事项及总结
文中使用的阿里云百炼平台的 api-key和 api 地址,需要去 百炼平台 提前申请。检索及存储向量时,要使用相同的向量处理模型和工具,注意向量维度也要保持一致。稠密向量维度要与 collection 中定义的保持一致。参考资料:https://help.aliyun.com/document_detail/2586282.html?spm=a2c4g.11174283.0.0.71af582bNPgka4
-

- 元宵节猜灯谜的祝福短信
- 角色扮演 |
-
- 关于柯南的沙雕网名有哪些
- 角色扮演 | 1
- 网名
-
- 最新中性名字男女通用网名有哪些
- 角色扮演 | 1
- 网名
-
- 关于蓝色说唱的网名有哪些
- 角色扮演 | 1
- 网名
-
- 我好喜欢你是什么梗?
- 角色扮演 |