AngelSpec - 腾讯混元团队开源的端到端推测解码训练框架
来源:互联网
时间:2026-07-31 14:14:31
AngelSpec是什么
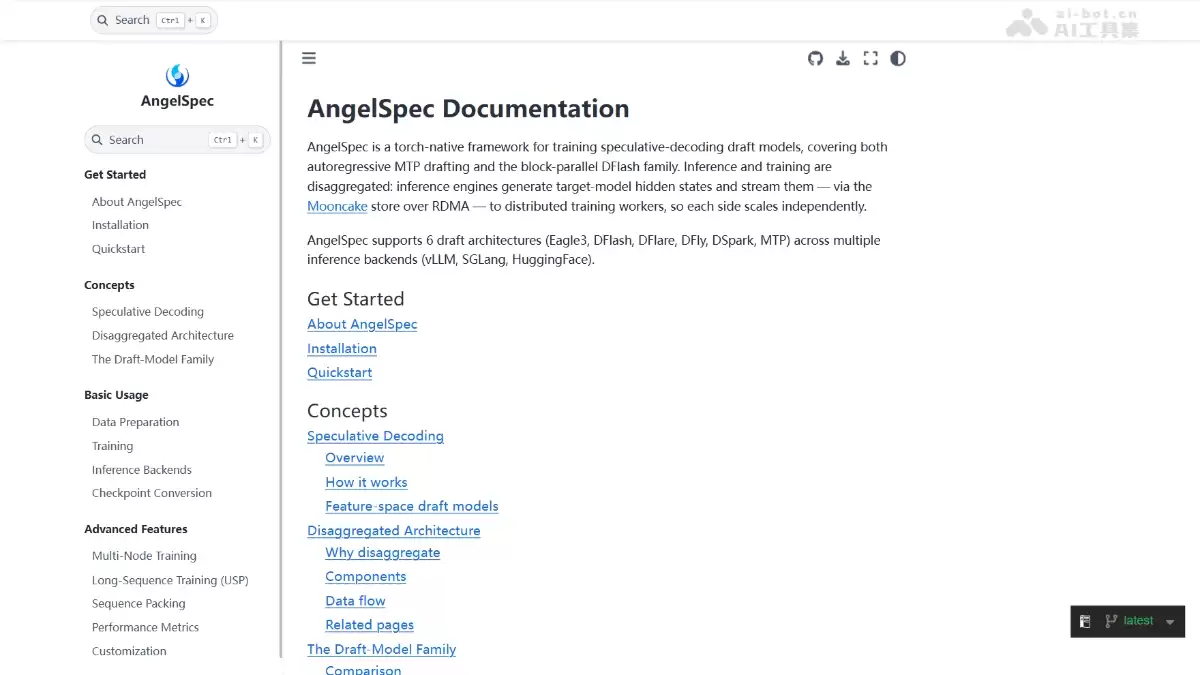
说起推测解码,大家可能已经不陌生了——它是在不改变大模型输出分布的前提下,让单步解码变成多步推进的核心手段。而腾讯混元团队开源的这款AngelSpec,则是一个端到端的推测解码训练框架,它基于TorchSpec构建,一口气支持了MTP自回归与DFly块并行等6种不同的草稿架构。这里有个关键的设计思路:推理和训练是解耦的,推理引擎通过Mooncake/RDMA把隐藏状态流式传输给训练工作器。根据官方数据,在Hy3-A21B这个模型上,DFly架构实现了1.98到2.40倍的端到端加速,吞吐能力相比DFlash提升了10.5%到11.8%。
AngelSpec的主要功能
那么,AngelSpec到底能做什么?简单来说,它把推测解码的训练流程整合得相当统一。
- :DFly、DFlash、DFlare、Eagle3、DSpark、MTP——这六种方案共享一条训练流水线,切换架构只需改个配置,这在工程落地时非常友好。
六种草稿架构统一训练
- :支持多深度自回归展开训练,内存占用接近单次因果前向的水平,配合Ulysses序列并行,最长可以处理128k的上下文。
MTP训练与TTT展开
- :支持CE、top-k KL、LK Loss、D-PACE加权以及端到端TV损失,而且这些损失函数可以通过配置自由组合,灵活性很高。
接受率对齐目标函数
- :采用Megatron风格的固定长度打包,严格做到了跨文档隔离,同时覆盖了DFlash和MTP两条路径。
文档感知序列打包
- :训练期间就能通过vLLM等引擎执行真实的推测解码,实时报告平均接受长度和逐位接受率,省去了很多后验调试的麻烦。
在线真实评估
- :vLLM、SGLang、HuggingFace这些主流推理引擎都能兼容接入。
多推理后端支持
AngelSpec的技术原理
从一个更底层的视角来看,AngelSpec的核心技术原理可以拆解为几个关键点。
- :AngelSpec的根基是推测解码——一个轻量级的草稿模型并行提出多个未来的token,然后目标大模型通过一次前向传播,用拒绝采样的方式批量验证。这个机制的核心挑战在于草稿接受率与验证开销之间的权衡,而AngelSpec从训练、架构和推理三个层面给出了系统性的解决方案。
推测解码基础
- :一个很容易被忽视的问题是,在线请求的异构性其实非常大——开放式对话、代码生成、数学推理、工具调用,这些场景的条件熵和延续结构差异显著。高熵对话场景下,接受率随深度快速衰减,适合短序列自回归草稿;而代码与数学场景往往存在长可预测的跨度,适合块并行扩散草稿。因此,AngelSpec选择了训练互补的专用草稿器——MTP面向对话数据,DFly面向代码与数学数据,而不是盲目追求一个通用的万能模型。
工作负载异构性建模
- :MTP草稿器采用了一种共享参数的多深度训练方案。所有逻辑预测深度复用同一个物理MTP模块,在训练时自回归展开:深度k+1接收深度k的argmax预测,同时维护逐层增长的草稿KV缓存与对角线注意力掩码。Training-Time Test(TTT)机制的存在,让草稿器暴露在了推理时可能遇到的自生成轨迹分布中,从而消除了教师强制带来的暴露偏差,显著改善了第二、第三草稿位的接受率。
共享参数多深度MTP训练
如何使用AngelSpec
如果想把AngelSpec跑起来,流程其实并不复杂。官方提供了非常清晰的指引。
- :执行
环境安装
pip install -e ".[vllm]"和pip install mooncake-transfer-engine,就能安装框架及vLLM后端。 - :比如用8张GPU,划分4张给推理、4张给训练,然后运行
单节点快速启动
./examples/qwen3-8b-dfly/run.sh,一条完整的流水线就启动了。 - :通过CLI直接覆盖YAML配置项,比如
配置覆盖
training.learning_rate=5e-5 training.num_train_steps=500,非常灵活。 - :运行
Conda环境搭建
./tools/build_conda.sh 1 vllm,可以一键构建包含mooncake的隔离环境,激活后直接使用。 - :通过Inference Controller与Training Controller经Ray调度,结合Mooncake隐藏状态存储,实现跨节点解耦训练。
多节点部署
AngelSpec的核心优势
总结下来,AngelSpec的优势其实相当明显。
- :MTP针对高熵对话场景优化,DFly针对代码与数学等长可预测跨度场景强化,避免了单一草稿模型在所有领域表现平庸的尴尬。
工作负载专业化
- :混合目标条件主干结合逐层目标视图,配合前驱条件自回归头,在保留并行生成能力的同时,提升了块内依赖建模的质量。
DFly架构创新
- :把目标验证视为共享的批次级资源,根据前缀置信度与运行时成本模型自适应调整验证深度,在高并发下能持续转化额外负载为吞吐。
D-Cut动态验证
- :推理与训练GPU池通过Mooncake存储解耦,双方可以按各自负载独立扩缩容,避免了统一并行策略带来的次优问题。
分离式独立扩展
- :同步释放了框架代码、Hy3-A21B/Qwen3-8B的MTP与DFly草稿权重、训练配置及技术报告,真正做到了开箱即用。
开源完整套件
AngelSpec的项目地址
- :https://angelspec.readthedocs.io/
项目官网
- :https://github.com/Tencent/AngelSpec
GitHub仓库
- :https://huggingface.co/collections/AngelSlim/angelspec
HuggingFace模型库
- :https://arxiv.org/pdf/2607.25852
arXiv技术论文
AngelSpec的同类竞品对比
和目前社区里比较有代表性的SpecForge相比,AngelSpec有一个很明显的差异化定位:它不是一个只针对EAGLE-3的框架,而是一个统一了MTP和块并行推测解码的训练框架。从对比数据来看,腾讯混元团队在Hy3-A21B上实现了1.98–2.40倍的加速,相比DFlash提升了10.5%–11.8%,这个成绩在同领域里相当有竞争力。
| 对比维度 | AngelSpec | SpecForge |
|---|---|---|
| 出品方 | 腾讯混元团队 | SGLang / 美团等社区团队 |
| 核心定位 | 统一MTP + 块并行推测解码训练框架 | 面向EAGLE-3的生产级训练框架 |
| 草稿架构 | 6种(DFly、DFlash、DFlare、Eagle3、DSpark、MTP) | 以EAGLE-3为主,支持主流开源模型 |
| 架构特色 | DFly混合目标条件 + 前驱自回归头 + D-Cut动态验证 | 目标-草稿解耦混合并行 + TTT稀疏树注意力优化 |
| 分离设计 | 推理/训练完全解耦,经Mooncake/RDMA流传输隐藏状态 | 支持同机共存与跨节点分离,通过SGLang后端集成 |
| 训练优化 | 接受率对齐目标(TV/LK/D-PACE)+ 文档感知打包 | FlexAttention稀疏掩码 + 原地梯度内核,内存降93.5% |
| 开源模型 | Hy3-A21B、Qwen3-8B的MTP/DFly权重 | SpecBundle(Llama、Qwen、Kimi、DeepSeek等EAGLE-3草稿) |
| 性能数据 | Hy3-A21B上1.98–2.40×加速,较DFlash高10.5–11.8% | Qwen3-235B训练加速9.99×,推理最高4.48×加速 |
| 推理后端 | vLLM、SGLang、HuggingFace | SGLang、HuggingFace、自定义后端 |
AngelSpec的应用场景
最后,聊聊AngelSpec能用在哪里。从实际需求出发,它的应用场景相当广泛:
- :为混元Hy3、Qwen3等MoE或稠密模型部署推测解码草稿,有效降低自回归解码的延迟。
大模型在线推理加速
- :利用D-Cut动态资源分配,在并发4到64的范围内维持最高平均吞吐,非常适合客服与助手场景。
高并发对话服务
- :通过DFly块并行草稿捕获长可预测跨度,加速IDE补全、解题引擎等结构化输出任务。
代码生成与数学推理
- :借助Ulysses序列并行支持128k上下文,适合文档分析、代码库检索等长序列场景。
长上下文训练与推理
-

- 元宵节猜灯谜的祝福短信
- 角色扮演 |
-
- 关于柯南的沙雕网名有哪些
- 角色扮演 | 1
- 网名
-
- 最新中性名字男女通用网名有哪些
- 角色扮演 | 1
- 网名
-
- 关于蓝色说唱的网名有哪些
- 角色扮演 | 1
- 网名
-
- 我好喜欢你是什么梗?
- 角色扮演 |