抢完互联网数据,AI公司开始抢绝版纸质书
2026年4月,一个专营稀有书和低流通量图书的美国书商,碰上了一件怪事。他店里生意向来不算火爆,一周能卖出二十本,已经算得上丰收。可最近,订单突然像潮水一样涌来,每周能卖出去几百本。最让人费解的是,买家只列出一份用国际标准书号(ISBN)索引的清单,既不问品相,也不砍价。
地球的另一端,荷兰哈勒姆的古董书商彼得·德弗里斯(Pieter de Vries)收到了一封来自新加坡公司2077AI的邮件,对方想采购近3000本书。几乎同一时间,德国、瑞士、西班牙的旧书商也纷纷接到了来自加拿大公司Zoom Books的大批量订单。这些书涉及的领域五花八门,根本看不出有什么明确意图。
这世界上,怎么突然冒出来这么多求知若渴的“人”?荷兰当地媒体开始调查,结果发现,这些订单既不像普通藏家所为,也看不出是学校或图书馆的采购。
直到Anthropic的一则秘密扫描项目曝光,所有线索才汇集到一起,真相浮出水面:订单的来源是几家AI公司,它们买到的书会被扫描,然后喂给大模型,落得个尸骨无存的下场。
大模型行业,正在上演现实版的“饥饿游戏”。
在收集实体书日益成为小众爱好的今天,AI厂商为什么忽然盯上了书商们的书架?这还得从2024年延续至今的大模型数据危机说起。
说到底,驱动大模型智能的核心,是海量的高质量文本。过去几年,训练数据的主要来源是互联网:维基百科、Reddit、新闻网站、博客、开放论文……但很快,生成式AI爆发,大量AI生成的文本涌入网络,反过来污染了互联网语料库。这导致模型在自己的输出上反复训练,质量螺旋式退化,最终趋于胡言乱语。研究者把这种现象称为“模型坍塌”(model collapse)。
于是,2022年之前出版的纸质书,就成了最后的干净数据源。它们主要由人类撰写、编辑、校对,语言精炼、结构完整,物理层面上根本不可能包含AI生成内容。正如图书元数据数据库公司ISBNdb所说:“世界上最好的AI训练数据,正摆在书架上。”
文本的纯净度是一方面,竞争维度同样关键。书商手里握着不少发行量极少的稀有书籍,如果一家AI公司把它全买回来,扫描后再销毁,就能成为自家模型的独有优势。书架,就这么变成了“兵家必争之地”。
只不过,书跟网页不一样,不能直接抓取。要把它变成训练数据,得用上一些更暴力的破坏手段。
2026年初,一份由美国地区法院解封的4000多页法庭文件,揭开了Anthropic公司内部一个代号“巴拿马计划”(Project Panama)的秘密项目。
项目始于2024年初。在此之前,Anthropic联合创始人本·曼恩(Ben Mann)在2021年个人下载了数百万本来自影子图书馆LibGen和Books3的盗版书籍,用于早期模型训练。这些行为给公司带来了严重的法律风险。
为了找一条更安全的路径,2024年2月,Anthropic聘请了谷歌图书(Google Books)项目的前合作负责人汤姆·图尔维(Tom Turvey)。内部规划文件毫不掩饰地写道:“巴拿马计划代表了我们破坏性扫描世界上所有书籍的努力。”
流程大致是这样的:公司先从大型二手书商处大量采购纸质书;这些书被切掉书脊,再经由高速工业扫描仪逐页数字化;扫描完成后,纸张作为回收物处理,不留实体副本。按照项目供应商的说法,这个计划的规模是六个月内处理50万到200万本书,整个项目只花了几千万美元,放在模型训练的总开销里,微不足道。
同样是做大规模书籍数字化,汤姆当年负责的谷歌图书保留了实体原件,并向公众开放了搜索和片段浏览;“巴拿马计划”却截然不同——它在提取内容后销毁书籍,全程保密,产出的数字副本也只供内部使用,永远不会向公众开放。
Anthropic内部很清楚,这件事一旦暴露,会引发汹涌的舆论攻击。但整件事最荒谬的地方在于,“巴拿马计划”的每一步,在美国现行法律下都是合法的。换句话说,AI公司几乎不会为此付出任何实际代价。
合法的荒谬
2025年6月,加利福尼亚北区联邦地区法院法官威廉·阿尔萨普(William Alsup)在Bartz诉Anthropic一案中作出裁定:扫描合法购买的实体书用于AI训练,属于“转化性合理使用”,受美国版权法第107条保护。
这裁定的逻辑分三步:第一,书是合法购买的,依据首次销售原则,买家有权处置;第二,每本纸质书都在购买后被复制为数字版,因此具备转化性;第三,数字副本没有被再分发、销售或对外展示。三项条件成立,所以属于合理使用。
这段推理无意中创造了一个悖论:销毁原件,反而让AI企业在法庭上更有利。企业可以主张,是为了节省存储空间和便于检索,用数字副本“替代”了实体副本。这在客观效果上,奖励了销毁行为。此后,在涉及OpenAI和Meta的独立版权案件中,其他联邦法官也作出了类似裁定。
更诡异的是,要想合法扫描并销毁,还得用正版书。
Anthropic早年使用的影印扫描书籍,已经被认定属于违法侵权。2026年7月20日,法官阿拉塞莉·马丁内斯-奥尔金(Araceli Martinez-Olguin)批准了15亿美元的最终和解协议,覆盖48万余部作品。截至2026年5月,Anthropic的年营收已达470亿美元,这笔和解金只占其中的3%。
法律开了绿灯,规模也足够可观,但问题是,这个项目为什么能藏这么久?
无法溯源的影子产业链
前面提到的ISBNdb,是理解这条隐秘产业链的关键节点。
这家公司成立于2001年,原本是为图书馆、书店和出版商提供书籍索引服务的元数据平台,其目录中收录了超过1.11亿本书。随着AI行业爆发,它转型成了AI公司批量采购书籍的中间商。
ISBNdb在网站上公开营销:“为大模型训练需求定制印刷书籍采购服务,以AI所需的规模交付。”并承诺,能获取散落在图书馆书架、二手书店和绝版目录中的书籍,每单规模从1000本到100万本不等。它还提供严格的保密协议:“你的身份、策略和采购目标永远不会被披露。”
在一则博客中,ISBNdb甚至大言不惭地承认:“舆论压力确实存在。(帮助)‘AI公司销毁两百万本书’并不是一个能博得同情的说法。”还试图重构叙事,强调纸张会作为回收物重新进入供应链,并把整个行为定义为“数字化保存”。
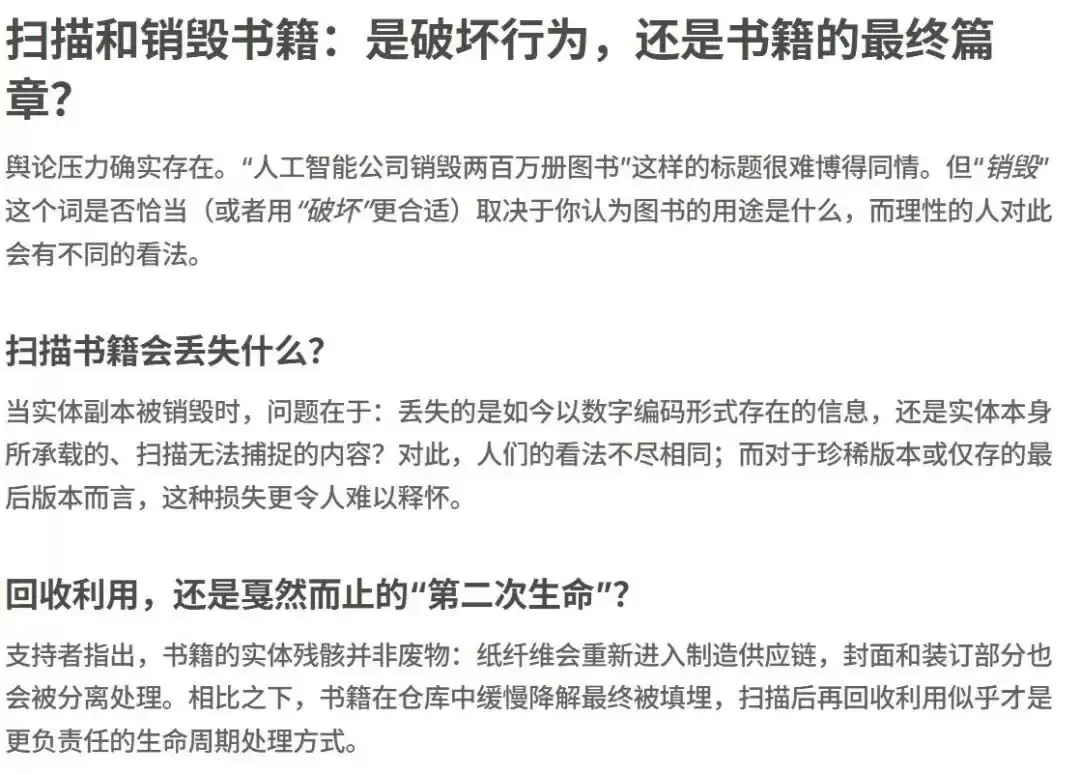
(来源:ISBNdb)
7月底,产业链彻底曝光后,ISBNdb删除了网站上的AI采购专页以及关于保密协议的承诺表述。但很快,该页面又恢复上线,甚至引用了威廉法官在Bartz案中的判决作为法律背书,大张旗鼓地继续做生意。
当然,ISBNdb不是唯一的中间商。新加坡的2077AI、加拿大的Zoom Books都曾出现在欧洲书商的采购邮件里,但依然没人知道委托它们购书的大客户是谁。
不可能吃饱
AI公司为了获取数据,正在不可逆地消耗人类文化遗产。但即使把全世界的书架都搬空,可能也解决不了AI的根本问题。
数据统计显示,人类历史上总共出版过约1.3亿本独特书籍,能提供大约30到40万亿tokens的文本量。而下一代大语言模型需要的训练数据,或将达到100万亿tokens量级——就算把有史以来所有的书都扫完,也喂不饱它们的需求。
以Anthropic为首的AI公司的做法,已经在业内激起巨大波澜。
埃隆·马斯克(Elon Musk)称,他已要求自己旗下的AI团队保留稀有书籍,用非破坏性方式扫描。前AI行业高管、非营利组织“公平训练”(Fairly Trained)创始人埃德·牛顿-雷克斯(Ed Newton-Rex)表示,巴拿马计划的曝光,是科技巨头与创作者之间权力失衡的又一证据。
白宫科学与技术顾问委员会主席大卫·萨克斯(Da vid Sacks)则一针见血:“Anthropic坚持认为它有权免费用全世界的产出来训练,即使作者反对。但如果竞争对手在付费之后用Anthropic的输出来训练,就是知识产权盗窃。这种伪善,令人叹为观止。”
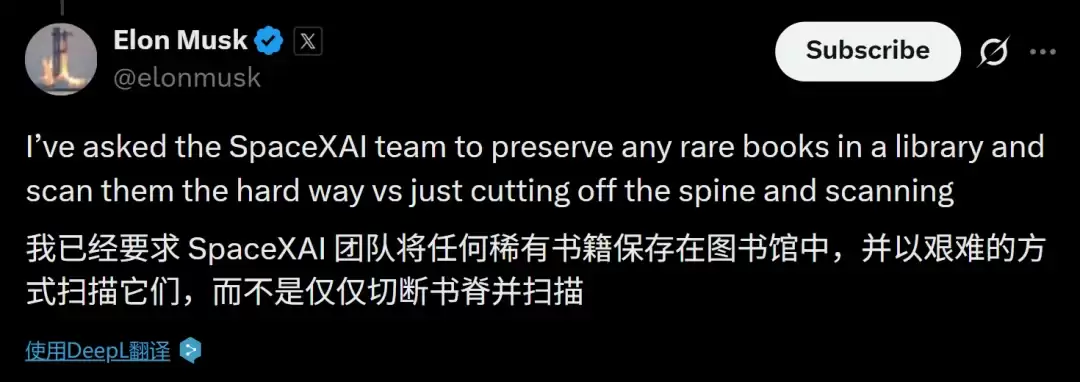
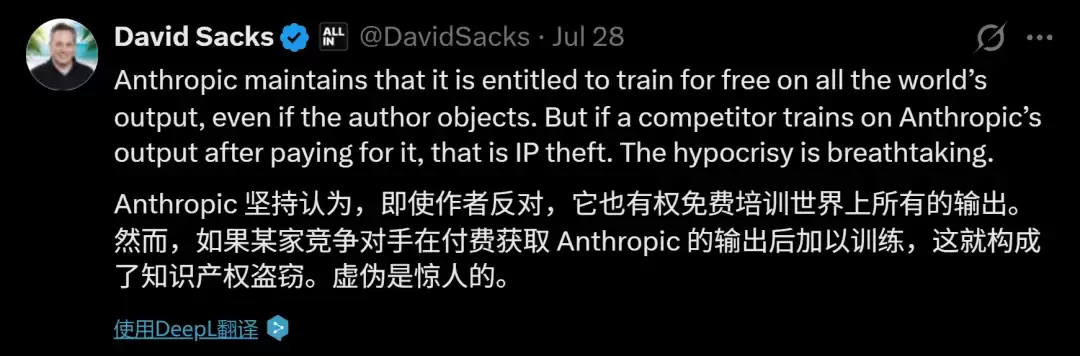
(来源:X)
此前多起与AI训练有关的版权诉讼中,作者群体的愤怒是普遍且合理的:AI公司在未经许可、未给予补偿的情况下,把创造性劳动变成了商业AI产品的原材料。
这一次,Anthropic买下的书籍,作者可能在几十乃至数百年前就已去世,著作权的追讨无从谈起,但其规模之巨,已经对人类文明构成了打击。
回到开头,那位察觉到自己生意突然变好的美国书商,在采访中流露出一种复杂的犹豫:“我个人对这一切的感受很复杂。它在经济上对我有利,也帮我清掉了不太可能卖出去的老书。我的库房里有很多来自海外和外语的书籍,的确很适合做这种生意。但另一方面,我不喜欢这个最终用途,我不喜欢这些稀有的书籍被变成纸浆。”
参考内容:
https://www.washingtonpost.com/technology/2026/01/27/anthropic-ai-scan-destroy-books/
https://www.404media.co/ai-companies-are-buying-tons-of-old-books-because-theyre-free-of-ai-slop/
https://www.courtlistener.com/docket/69058235/bartz-v-anthropic-pbc/
https://isbndb.com/blog/print-books-sourcing-ai-training/
注:封面/首图由 AI 辅助生成
-

- 元宵节猜灯谜的祝福短信
- 角色扮演 |
-
- 关于柯南的沙雕网名有哪些
- 角色扮演 | 1
- 网名
-
- 最新中性名字男女通用网名有哪些
- 角色扮演 | 1
- 网名
-
- 关于蓝色说唱的网名有哪些
- 角色扮演 | 1
- 网名
-
- 我好喜欢你是什么梗?
- 角色扮演 |