阿里云 Elasticsearch 9.4 Agent Builder 实战
开篇:一条告警,为什么总要查这么久
可能不少人都经历过类似的场景:一条5xx告警弹出来,确认“服务在报错”只需要几秒钟。但接下来的调查,才是真正让人头疼的部分。找索引、选时间窗口、写查询、比版本、提取trace、翻发布记录、核对回滚规则、整理审批单……难的不是单个步骤,难的是把这些步骤串起来做。而且,换个人来查,口径和顺序很可能又不一样。更关键的是,这些经验往往只存在于个别工程师的脑子里,既没法复用,也没法审计。
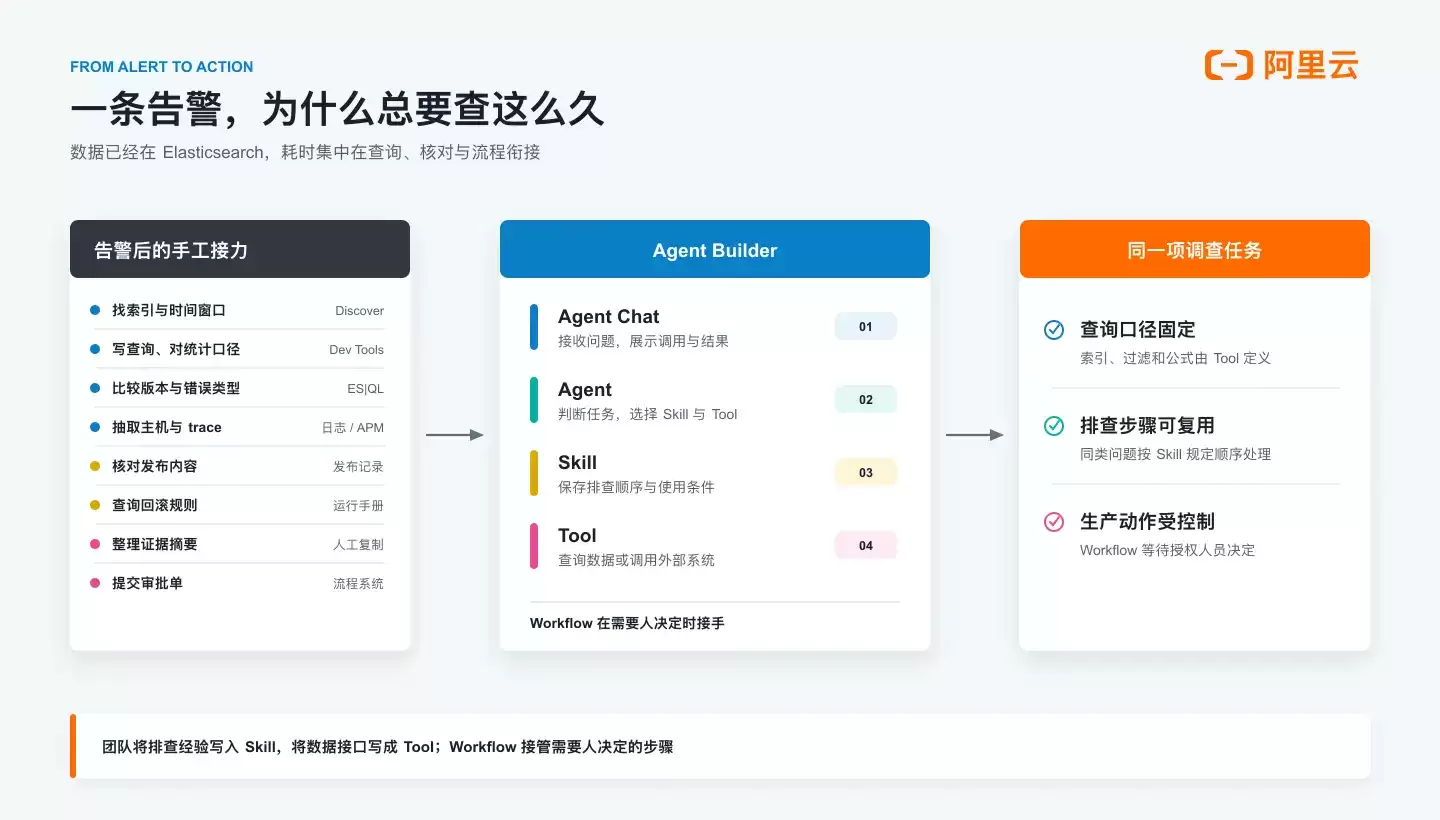
阿里云Elasticsearch 9.4的Agent Builder,本质上就是把这一整套排查链条收拢到一处。整个排查流程被设计成Skill,数据接口封装成Tool,Agent根据用户请求来组织调用顺序。碰到需要人拍板的环节,就交给Workflow处理。查询依然走Elasticsearch自身的权限体系,生产动作继续走既有的审批流程。这样一来,能力可以复用,边界也得以守住。
Agent Builder的核心对象并不复杂,主要就是四个:Agent Chat、Agent、Skill、Tool。Workflow通过Workflow Tool与Agent协作,专门处理那些需要人工确认的确定性流程。下面就拿一次灰度发布引发的登录故障,来完整走一遍流程。演示运行在阿里云Elasticsearch 9.4实例上,大模型通过AI Connector接入AlibabaCloud AI Search接口(演示模型用了qwen3-max)。所有日志统计、发布记录、策略阈值和流程状态,都是实际调用返回的数据。
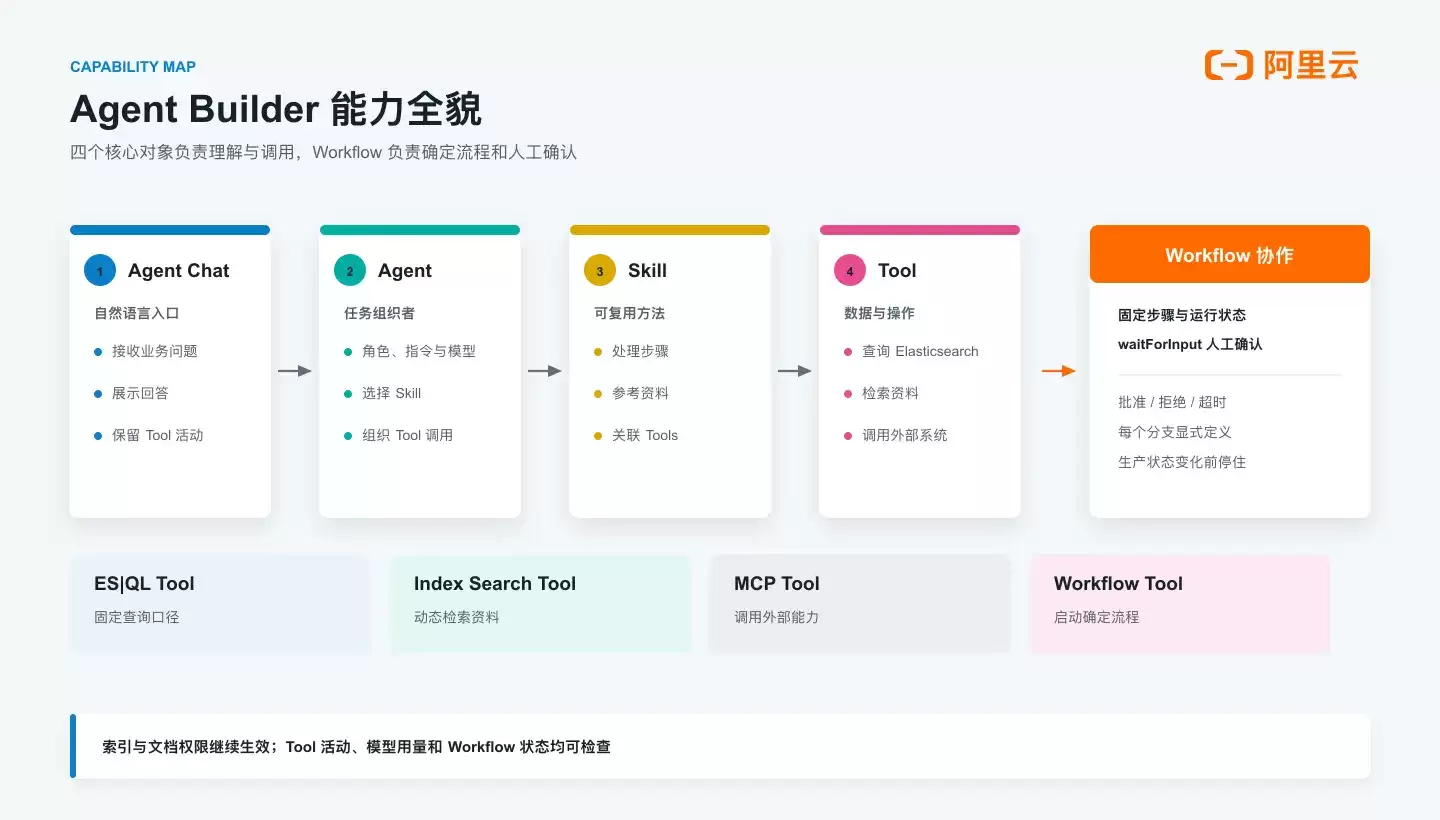
登录接口触发5xx告警,灰度发布刚过去十几分钟。值班人员确认异常后,在Kibana Agent Chat里输入了一句话:
分析最近13分钟的登录失败日志。影响有多大?错误集中在哪个版本?十几分钟前刚发布的auth-service灰度版本是否相关?如果已经满足回滚条件,请发起审批。
一句话里包含了四个子任务:定量影响面、定位版本、关联发布、触发审批。Agent会按照Skill规定的顺序逐步处理,而不是把所有查询一股脑丢给模型。下面分5个部分,对Demo中的具体操作做详细拆解。
一、数据基础:字段统一,权限锁死
调查要对比发布前后、对比稳定版本和灰度版本,前提是字段定义必须一致。时间、环境、服务、版本、状态码,如果各写各的,错误率根本没法比。
演示数据总共26,400条访问日志,按固定规则生成:发布前后各12,000条生产登录日志,另有1,200条staging登录日志和1,200条production支付服务日志。后两组不参与故障统计,专门用来验证权限隔离。
所有日志入库前,都会经过同一条Ingest Pipeline:校验必填字段,统一映射为@timestamp、service.name、service.version、http.response.status_code、trace.id、error.type、deployment.id,同时删除令牌和用户标识。
权限隔离才是关键所在。Agent使用的角色只能读取production环境的auth-service日志及对应发布策略,staging数据和支付服务日志对它完全不可见。用第二个演示账号验证,结果很明确:能查到24,000条生产登录日志,staging和支付服务返回0。也就是说,Agent看到的数据和人工查询完全一样,不会因为接了LLM就多看到任何东西。
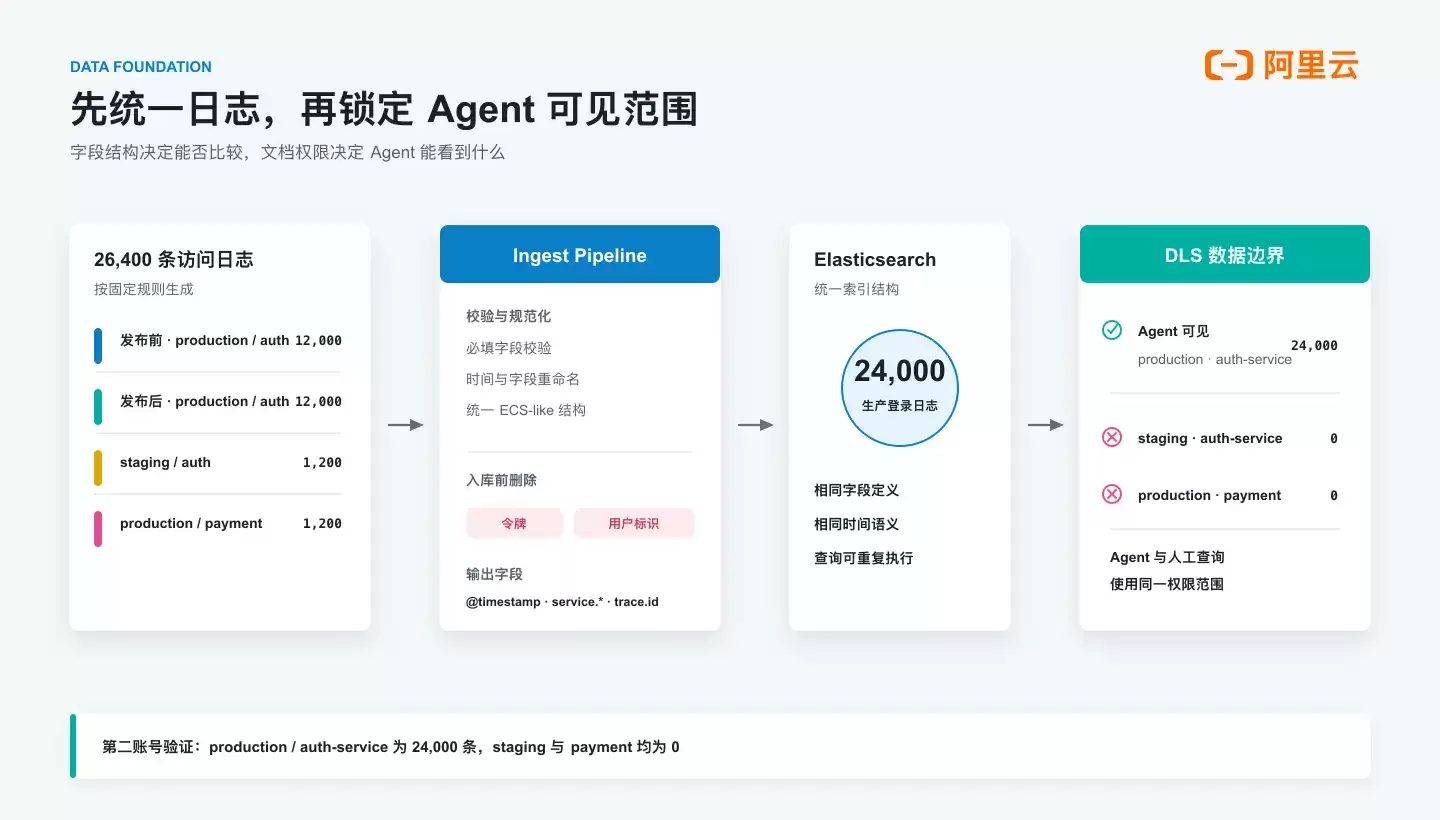
到这一步,字段结构和可见范围已经对齐,后续所有查询都可以在Kibana中重复执行。
二、定量:影响面有多大,问题在哪个版本
告警只告诉你“有5xx”,不告诉你多严重、谁在报错。Agent调用的第一项Tool是login_logs.summarize_failures——接收起止时间,用参数化ES|QL按版本统计请求量、5xx数量和错误率。
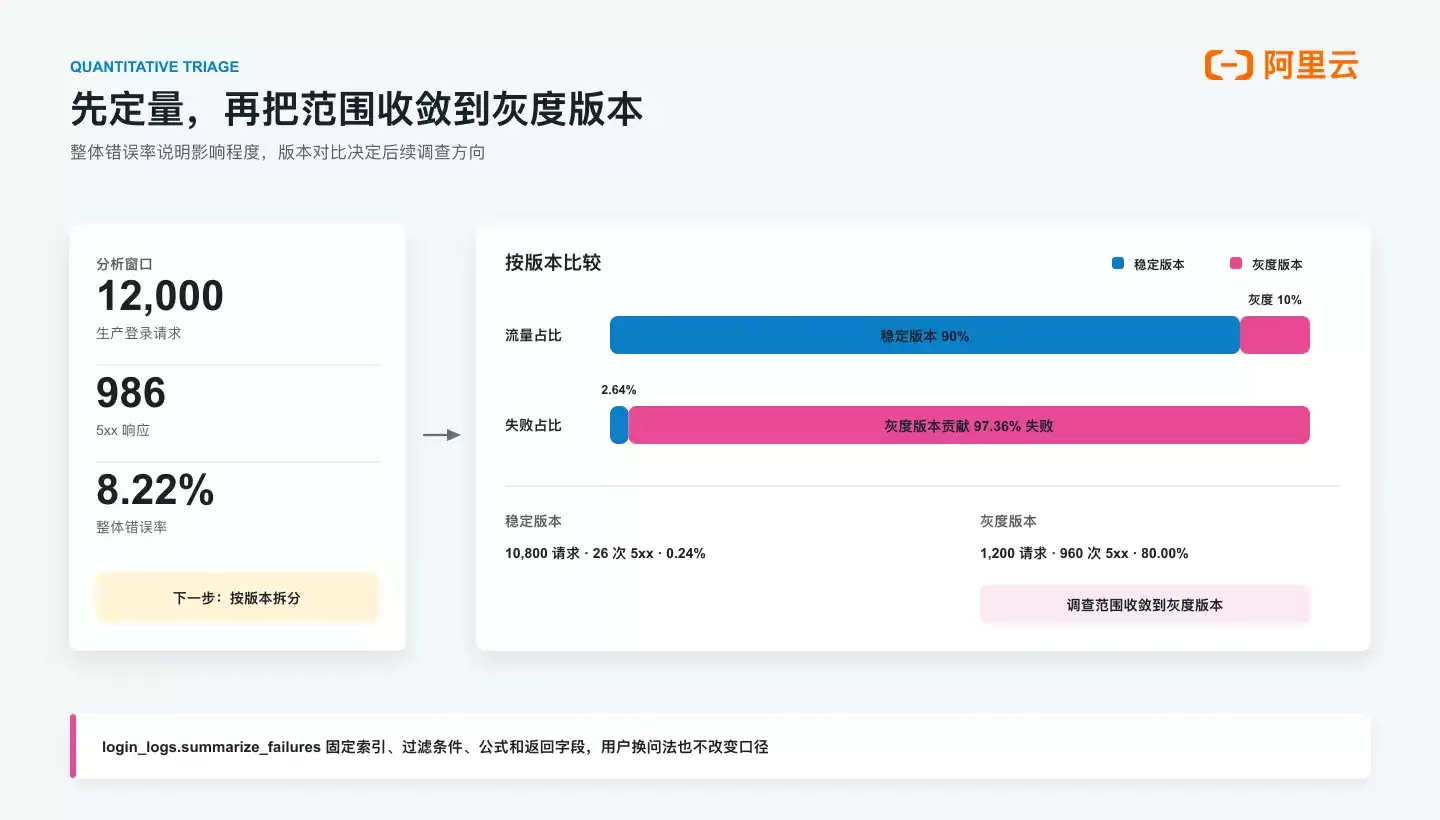
结果很清晰。分析窗口内总共12,000次生产登录请求,986次返回5xx,整体错误率8.22%。但按版本拆开看,灰度版本只承接了10%的流量,却贡献了97.36%的失败。稳定版本错误率0.24%,基本是背景噪声。方向已经很明确:后续调查集中在灰度版本。
值得注意,查询口径是写死在Tool里的——索引、环境、服务、接口、计算公式、返回字段都是预定义的。用户换个问法,底层查询不会跟着变。
三、深入灰度版本:什么错、哪台机器、哪条trace
知道“灰度版本在报错”还不够,还得知道报什么错。Agent接着调用两项Tool:
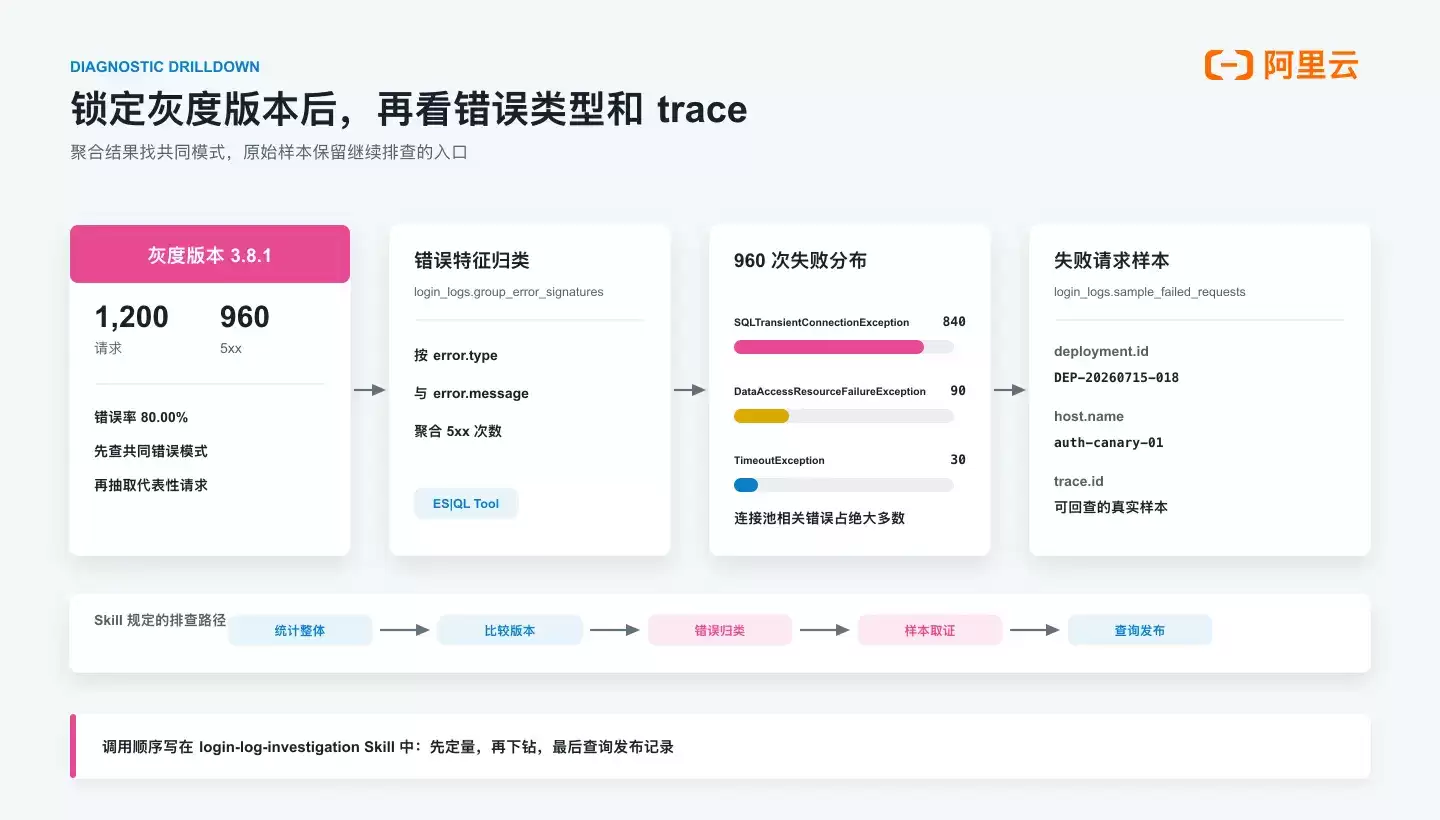
960次失败的分布:SQLTransientConnectionException 840次,DataAccessResourceFailureException 90次,TimeoutException 30次——几乎全跟数据库连接有关。样本还返回了deployment.id=DEP-20260715-018、主机名和trace.id,拿着这些就能去查调用链和应用日志。
这个调用顺序,不是模型自己随便发挥的。login-log-investigation Skill写死了排查路径:先统计整体和版本分布,错误集中时对异常版本做归类和取样,需要判断发布关联时再查发布记录和回滚规则。Skill还要求回答里标明分析窗口,区分“日志统计事实”“关联判断”和“待验证项”,避免把推测说成结论。
演示中还用到其他类型的Tool:Index Search Tool检索运行手册和历史排障资料,回滚阈值由参数化ES|QL Tool查正式策略记录,CMDB、工单、发布平台等外部系统则通过MCP Tool接入。四类Tool各有各的边界。
四、关联发布:那次灰度改了什么
错误全指向数据库连接池,而灰度版本恰好在告警前十几分钟刚发布。是巧合还是因果?得看发布记录和回滚规则怎么说。
login_logs.retrieve_release_policy返回两条关键信息:
- :灰度版本于告警前16分钟按10%流量发布,变更内容是把数据库连接池
发布记录
maxPoolSize从50调到10。 - (
回滚策略
POL-REL-ROLLBACK-002):灰度版本5xx错误率连续5分钟≥5%,且稳定版本<1%,即可发起回滚审批。
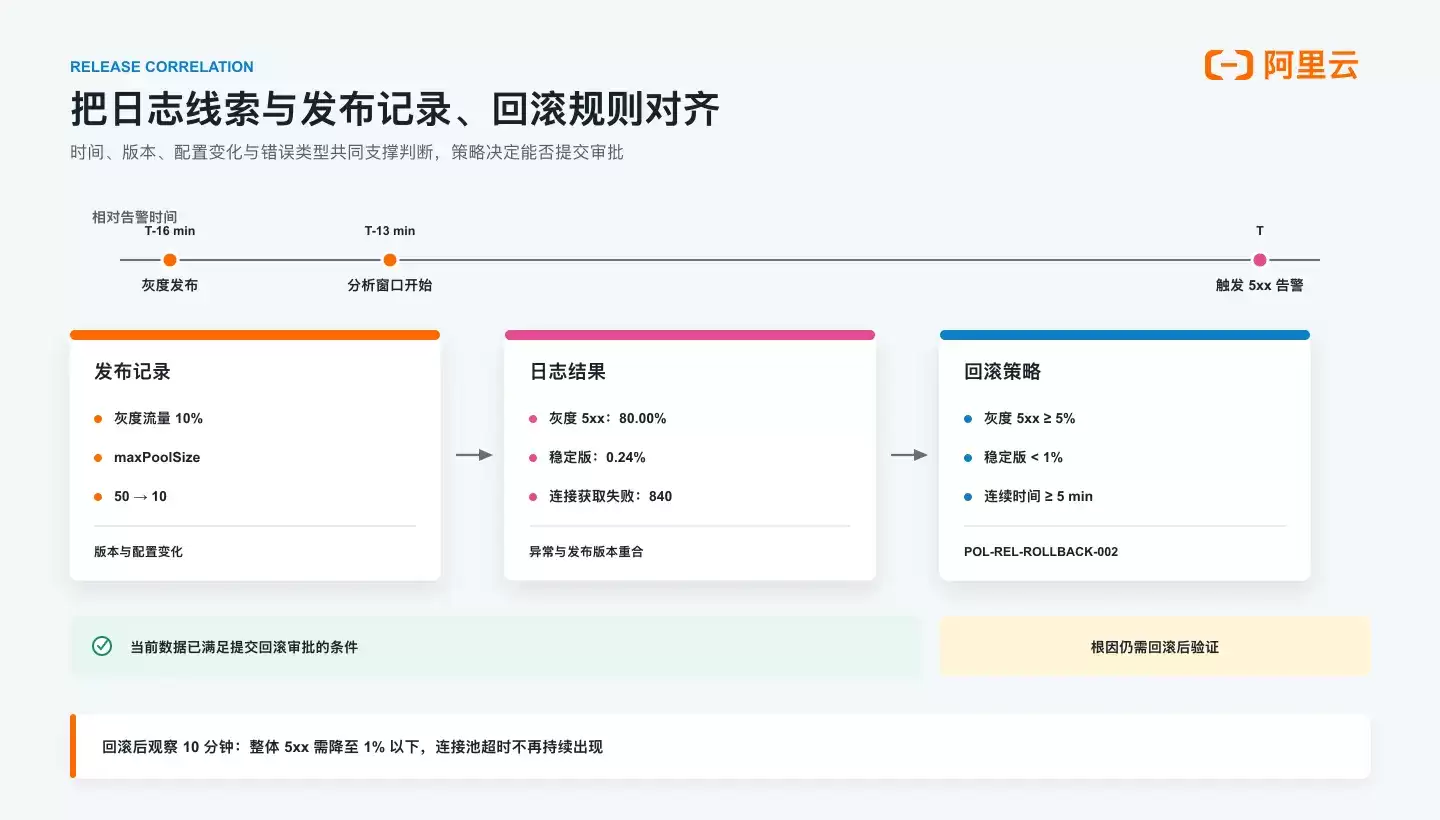
对照日志数据:灰度版本错误率80%,稳定版本0.24%,阈值条件完全满足。发布时间、配置变更(连接池缩容5倍)、错误类型(连接获取失败)三者完全吻合,足以提交回滚审批。当然,根因确认是回滚之后的事——观察指标是10分钟内整体5xx回落到1%以下,连接池超时不再持续出现。
五、审批:Workflow停住,等人拍板
Agent判断条件满足后,加载production-rollback-approval Skill。这个Skill专门做参数校验:服务名、异常版本、目标版本、分析窗口、证据摘要、策略编号、验证计划,七项缺一不可。全部齐全后,才调login_logs.request_rollback_approval启动Workflow。
Workflow走到waitForInput就停住了,状态变为Waiting。当班负责人看到版本、日志统计、策略编号和验证计划,然后决定批准、拒绝或要求补充材料。等待期间生产环境不会有任何变化。批准后Workflow状态变为Success。
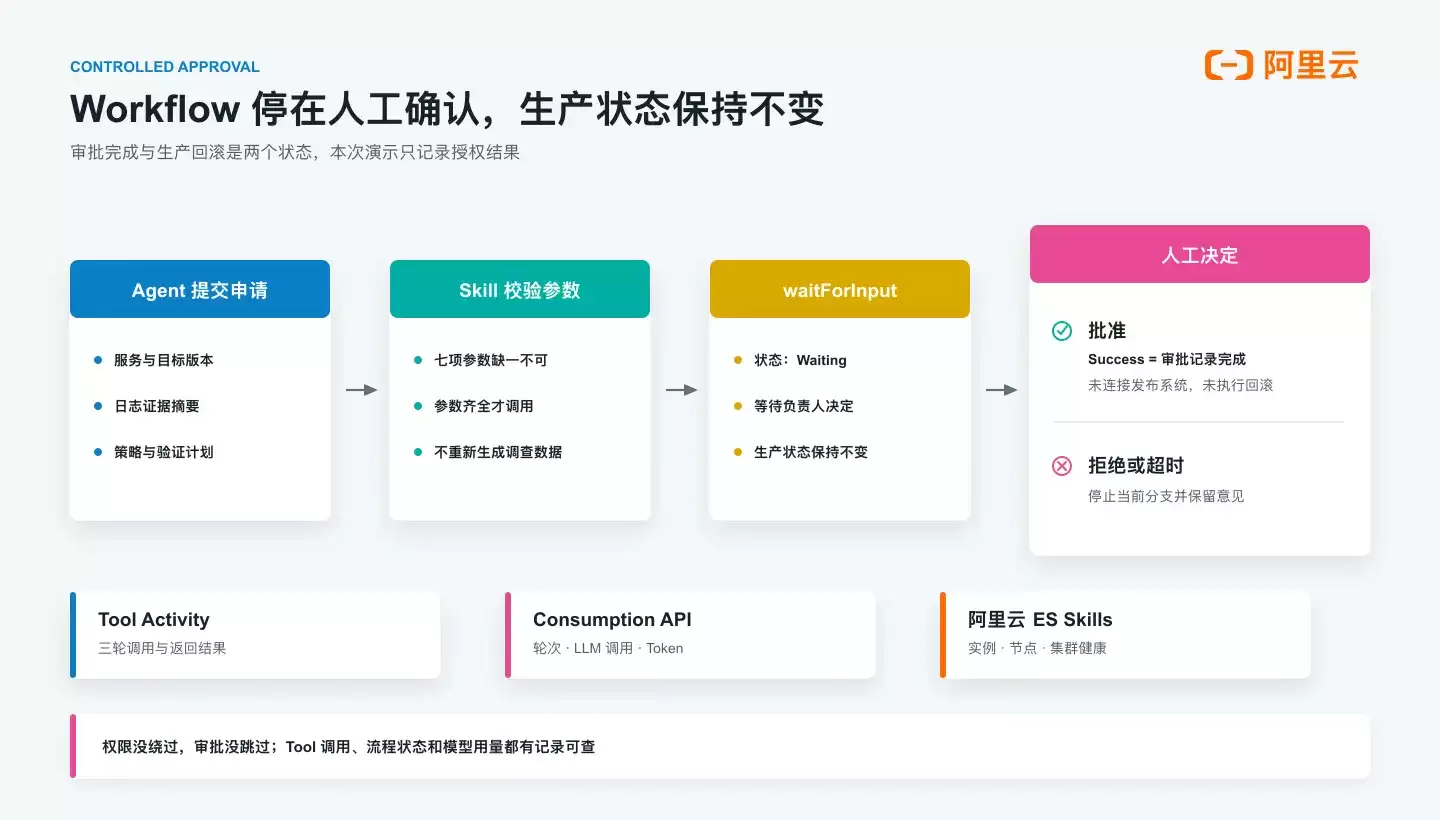
Agent Chat保留了三轮对话中所有Tool调用和返回结果,每一步判断都可以回溯。回顾整个过程:ES|QL Tool管查询,Skill管顺序,Agent根据上一步结果决定下一步调什么,Workflow管需要人签字的环节。权限没绕过,审批没跳过,每一步都有调用记录可查。
-

- 元宵节猜灯谜的祝福短信
- 角色扮演 |
-
- 关于柯南的沙雕网名有哪些
- 角色扮演 | 1
- 网名
-
- 最新中性名字男女通用网名有哪些
- 角色扮演 | 1
- 网名
-
- 关于蓝色说唱的网名有哪些
- 角色扮演 | 1
- 网名
-
- 我好喜欢你是什么梗?
- 角色扮演 |