Vibe Coding撞墙了?换个思路治好AI编程的「局部失忆」
Vibe Coding 这事儿,确实把开发门槛拉到了地板。但很多人发现,自家 Coding Agent 的表现,就像开盲盒:前 3 轮,那体验简直惊艳到让人头皮发麻——它会自己翻仓库、定位文件、刷刷刷写出第一版 Diff,甚至顺手把测试都跑了。你甚至会产生一种“人类程序员真要失业了”的错觉。
可是,一旦任务的上下文稍微复杂点、拉长点,剧情就开始急转直下。那个刚才还聪明伶俐的 Agent,会突然变成一个在“调试黑洞”里原地打转的路痴。测试跑挂了,它开始慌了,疯狂修改代码,一边道歉一边狂飙 Diff,连续输出 5 轮、8 轮、10 轮……到了第 10 轮,你深吸一口气,发现它不仅忘了一开始要干什么,甚至把第 2 轮就修好的 Bug 又给改了回去。
整个聊天窗口,最后塞满了报错信息和垃圾日志,环境噪声大得吓人。面对这个已经开始胡言乱语的 Agent,你唯一的选择就是手动掐断,新建一个会话。但更崩溃的还在后面——你不得不把过去一小时发生了什么、改了哪些文件、卡在哪个测试点,再跟新 Agent 用自然语言重新诉说一遍。这就像你打了半天游戏,存档丢了,得从头再来。
这其实就是目前 AI 编程工具,在真实工程里落地时最大的拦路虎:现在的 Agent 就像个信息垃圾桶,把所有的工程线索和垃圾噪音一股脑儿全塞进 Chat Context 里,独独缺了一层独立、结构化的 Engineering State 来做隔离与控制。
为了打破这个僵局,Valkor 联合浙江大学智能计算与软件研究中心、伦敦大学学院(UCL)软件工程团队,正式开源了 loom。
Loom 盯上的,不是 AI 能不能写代码,而是 AI 写完了代码,怎么让复杂的软件任务在真实工程流程里,持续、可验证、可恢复地往下走。
Claude Code、Codex 之后,AI 编程还缺什么?
过去一年,Code 模型的能力进化速度有目共睹。像 Claude Code 这样的 Agent,已经能深入到真实仓库,执行复杂的多文件修改。但问题在于,在真实的软件工程里,“会写第一版代码”和“完成一次可靠的交付”,中间隔着的距离,堪比马里亚纳海沟。这也是为什么 Vibe Coding 只能停留在搓 Demo 的阶段,而没法染指正经的业务重构。
一个真实的需求,从来不只是代码片段。它牵扯到前端交互行为、API 边界、数据库变更、单测覆盖率、运行时日志、CI 状态……这些动态状态,对工程师来说,分散在 Git、PR、CI 日志和自己的脑子里。但对 Agent 来说,如果这些状态只存在于聊天上下文里,那长任务失控几乎是必然的。
首先,上下文极易被报错噪音淹没。所有的编译报错、重试日志、临时推论,全堆在 Context 窗口里,导致模型在后续决策中,根本抓不住重点。更糟糕的是,会话一旦中断,或因为 Token 太多被截断压缩,Agent 就会陷入“局部失忆”,开始重复试错,对“正在做什么”和“做到哪里了”只能重新盲猜。
Loom 想补上的,正是软件工程本该给 Agent 提供的这层“工程状态层”。
从“一次性 Prompt”,到“可随时 Resume 的状态链”
Loom 的切入点简单直接:它给单机游戏引入了“自动存档点”。它把一次复杂的软件交付过程,拆解成结构化、可随时恢复的状态链。
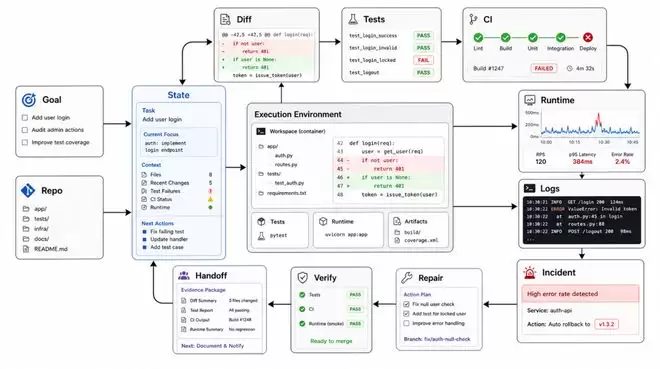
当 Agent 运行测试失败时,Loom 不会把这个失败,简单地当成一段终端文本丢进 Chat。它会捕捉这个失败,并将其结构化为一个独立于聊天记录而存在的待办状态。这意味着:
Bug 不会被淹没:失败变成了下一步行动的“强约束”。Agent 不可能在后续对话中,打个哈哈就把这个 Bug 漏过去。
多 Agent 零成本接管:未来的开发一定是多工具、多模型协作的。你可能前 5 轮用 Claude 4.6 Sonnet 改逻辑,第 6 轮想换成 GPT-5.5 跑测试。新 Agent 接入 Loom 后,只要读取结构化的“交付状态链”,就能瞬间明白自己是谁、在哪、刚才改了什么、下一步该修哪个 Bug。它不需要重新阅读冗长的聊天历史,直接原地“接管比赛”。
为什么靠卷 Context Window,治不好长任务的绝症?
很多人习惯把长任务失败,归咎于模型的 Context Window 不够长。但放在真实的工程逻辑里,这其实是个伪命题。
在软件开发中,信息量大不等于可靠性高。把几万行的编译日志、多轮 Diff、测试输出,一股脑儿全塞进上下文,只会让会话环境充满杂音。模型非常容易在繁杂的信息中迷失,或者把一个局部看起来能跑的代码,误判为完成。
工程的本质,是结构化与确定性。
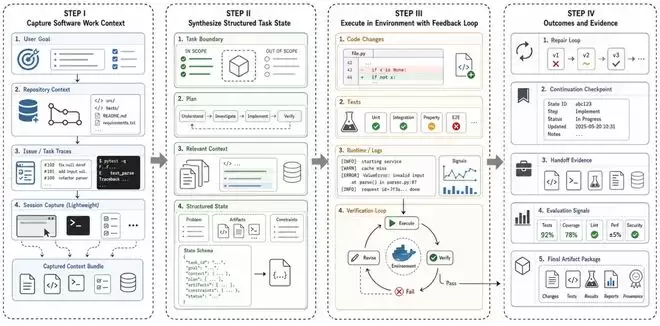
Loom 的思路不是让模型看更多、记更多,而是帮模型过滤噪音,只提炼出最核心的工程线索:计划进行到哪一步了?哪些单测真的 Pass 了?哪几个文件的 Diff 已经定型,不能再乱动了?当这些关键点成为可被编程读取的结构化数据时,衡量 AI Coding 效能的标准,也就从“模型能生成多少行代码”,真正变成了“长任务持续推进的完备率”。
软件工程:大模型真正落地的确定性沙盒
软件工程,可能是 Agent 最好的反馈场。这里的规则绝对刚性:代码能编译就是能编译,单测挂了就是挂了。AI 编程如果想走向严肃的生产环境,就必须重回软件工程的经典常识。
现在,依靠 Vibe Coding 确实能让所有人都能快速搓出一个 Demo。但 Demo 和能在生产环境跑的真实软件之间,还差了一整套可信度验证。如果 Coding Agent 只管写代码,把所有的验证、对齐、纠错成本全部甩给人类工程师,效率的杠杆很快就会见顶。从这个角度看,Loom 想探索的,不仅仅是一个好用的开源工具,而是大模型真正走向严肃生产环境时,所缺失的状态基础设施。
大模型在静态语料库里,学到了“完美的最终代码长什么样”,却很难学到“一个复杂的 Bug 到底是如何被一步步定位、失败、妥协并最终修复的”。而这些过程轨迹,才是软件工程中最核心的工程判断力。
通过这层状态层,Loom 不仅能让 Agent 的长任务推进更稳定,也在同时捕获 Agent 在真实执行环境下的动态反馈轨迹。这为未来 Agent 的动态评测和微调数据收集,提供了更真实的工程语料。
从模型生成代码,到 Agent 自主、持续、可验证地完成一个复杂的软件工程生命周期,中间这层缺失的状态基础设施,正为当下 AI Coding 技术的推进,提供一个值得被重新审视的重要视角。
-

- 元宵节猜灯谜的祝福短信
- 角色扮演 |
-
- 关于柯南的沙雕网名有哪些
- 角色扮演 | 1
- 网名
-
- 最新中性名字男女通用网名有哪些
- 角色扮演 | 1
- 网名
-
- 关于蓝色说唱的网名有哪些
- 角色扮演 | 1
- 网名
-
- 我好喜欢你是什么梗?
- 角色扮演 |