打破专用模型桎梏!谷歌 DeepMind 发布 GenCeption,一个 AI 搞定五大视觉任务
来源:互联网
时间:2026-07-22 15:36:11
谷歌 DeepMind 团队最近放出了一个很有意思的新东西——GenCeption 模型。简单来说,他们把传统的视频生成 AI 技术“反过来用”,做成了一个能深度理解现实世界的视觉分析引擎。过去做深度估计、图像分割、3D 姿态估计这些任务,通常得各自搭一套模型,各干各的。但 GenCeption 用一个模型就能同时搞定五项核心视觉任务,效率一下子拉高了不少。
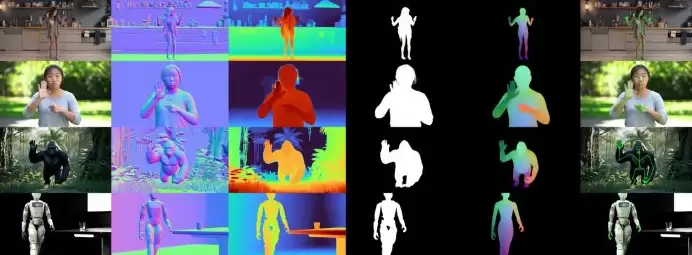
这个模型基于阿里巴巴开源的通义万相 Wan2.1 框架训练,只需要一次前向传播就能完成预测,处理速度大幅提升。你只要用简单的文本提示输入指令,模型就能直接输出深度图、分割掩码、相机运动轨迹这些丰富的信息,省去了很多中间步骤。
单人合成数据训练,泛化细节保留到发丝
有意思的是,GenCeption 的训练集其实非常“寒酸”——只用了约 7500 段由 Blender 渲染的单人合成视频数据。但它的泛化能力却让人意外,不仅能顺畅处理真实世界中的多人视频,还能轻松迁移到动物和机器人这些类别上。从实际测试来看,小模型处理 81 帧视频只需要大约 6 秒,140 亿参数的大模型也只要 10 秒左右。更夸张的是,它还原的细节甚至超过了训练用的合成原图,连猫的胡须和单根发丝边缘都能清晰保留下来。这背后的逻辑值得琢磨——合成数据训练出来的模型,反而在真实场景中表现得更“细腻”,某种程度上打破了“合成数据不行”的固有印象。
-

- 元宵节猜灯谜的祝福短信
- 角色扮演 |
-
- 关于柯南的沙雕网名有哪些
- 角色扮演 | 1
- 网名
-
- 最新中性名字男女通用网名有哪些
- 角色扮演 | 1
- 网名
-
- 关于蓝色说唱的网名有哪些
- 角色扮演 | 1
- 网名
-
- 我好喜欢你是什么梗?
- 角色扮演 |